Сканера нет. Но скан нужен прямо сейчас.
Сфотографируйте документ телефоном — вернётся PDF формата A4, который примут там, где просят скан.
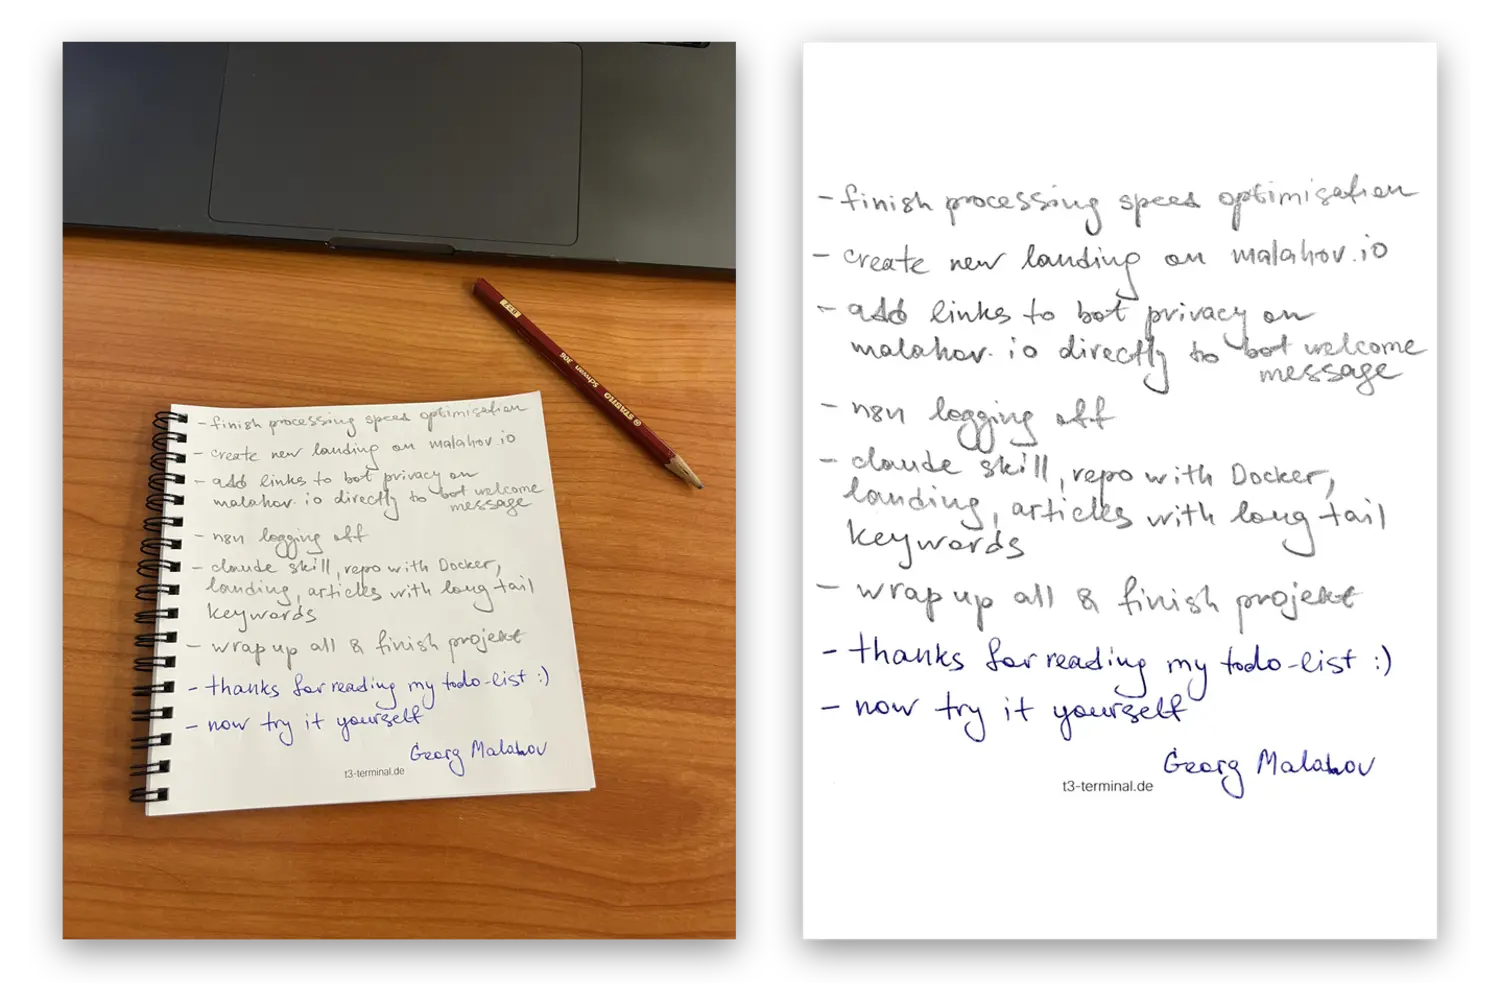
Фотография документа — это не скан.
Лист снят под углом, половина в тени, бумага серая, файл на четыре мегабайта. В ведомстве такое возвращают, а сканера под рукой нет.
Знакомо?
Это про вас, если…
Да
- Нужно отправить документ в ведомство, банк или страховую
- Сканера нет, а МФЦ или копи-шоп — это отдельная поездка
- Документ на бумаге, а форма загрузки просит PDF
- Страниц несколько, и нужны они одним файлом
Нет
- Нужно распознавание текста и поиск по содержимому
- Нужна подпись документа или юридическая сила
- Сканируете сотнями страниц в день
Что вы получаете
Ровный лист вместо снимка под углом
Четырёхугольник листа находится в кадре и разворачивается в прямоугольник.
Стол, тень и пружина исчезают
Всё, что заходит в кадр снаружи листа, стирается — включая кольца блокнота.
Бумага становится белой
Неровный свет от лампы и окна выравнивается, серая бумага становится белой.
Подпись остаётся синей
Чернила уходят в чёрный, но синяя подпись и красная печать сохраняют цвет.
Альбом — это один документ
Несколько снимков, отправленных вместе, вернутся одним многостраничным PDF.
Точный A4 в несколько сотен килобайт
Не «картинка в PDF», а страница нужного размера, которую примет любая форма загрузки.
Три шага
Ставить ничего не нужно — всё происходит в Telegram.
Пришлите снимок
Фотографию или файл. Несколько страниц — одним альбомом.
Заберите PDF
Обычно около полуминуты на страницу. Бот напишет, когда готово.
До и после
Два настоящих снимка и два настоящих результата, без ретуши.
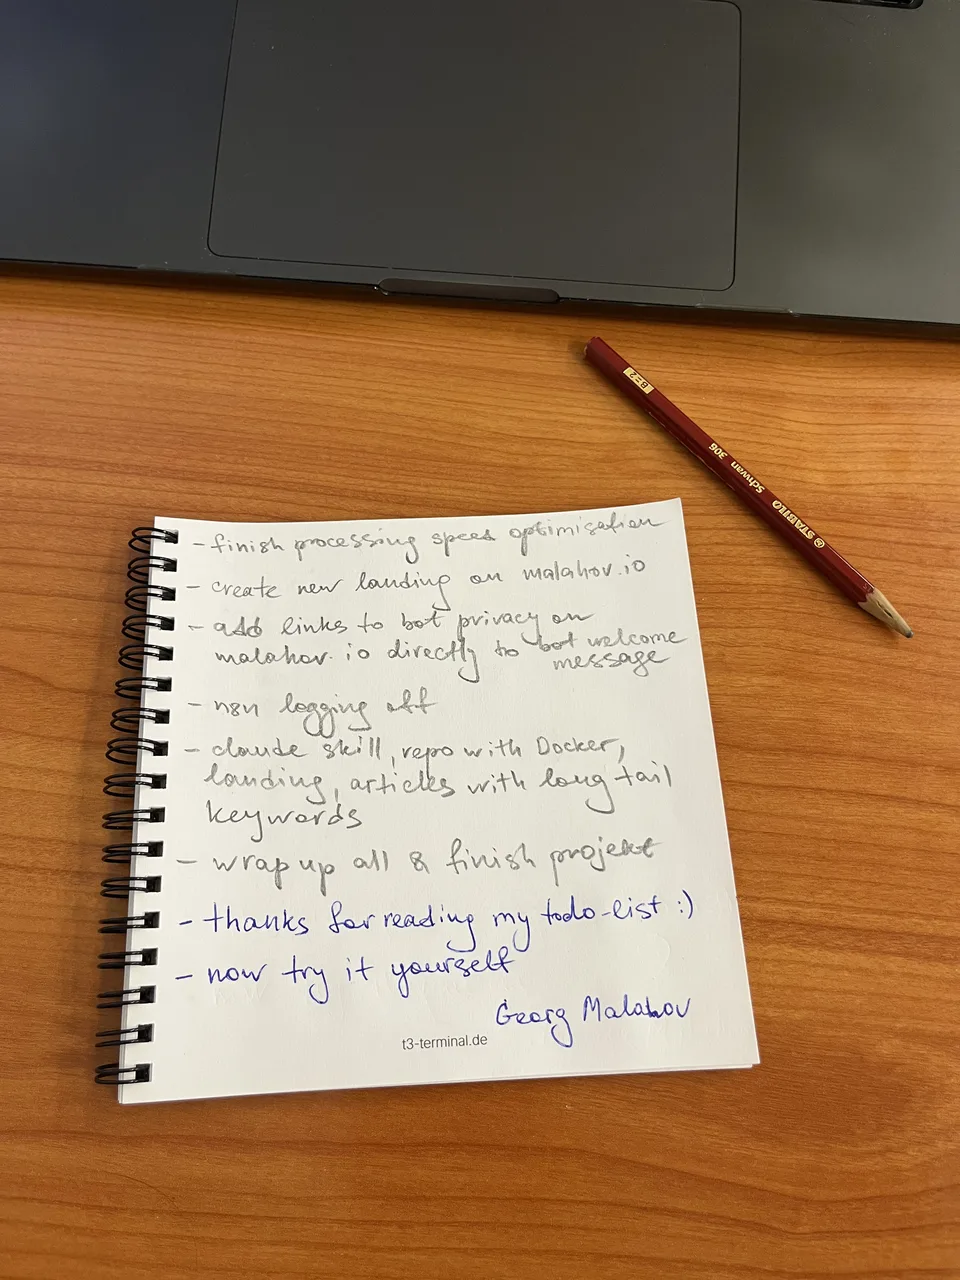
Снято телефоном со стола: угол, тени, тёплый тон от дерева, пружина в кадре. Верх списка — карандашом, последние строки и подпись — синей ручкой.
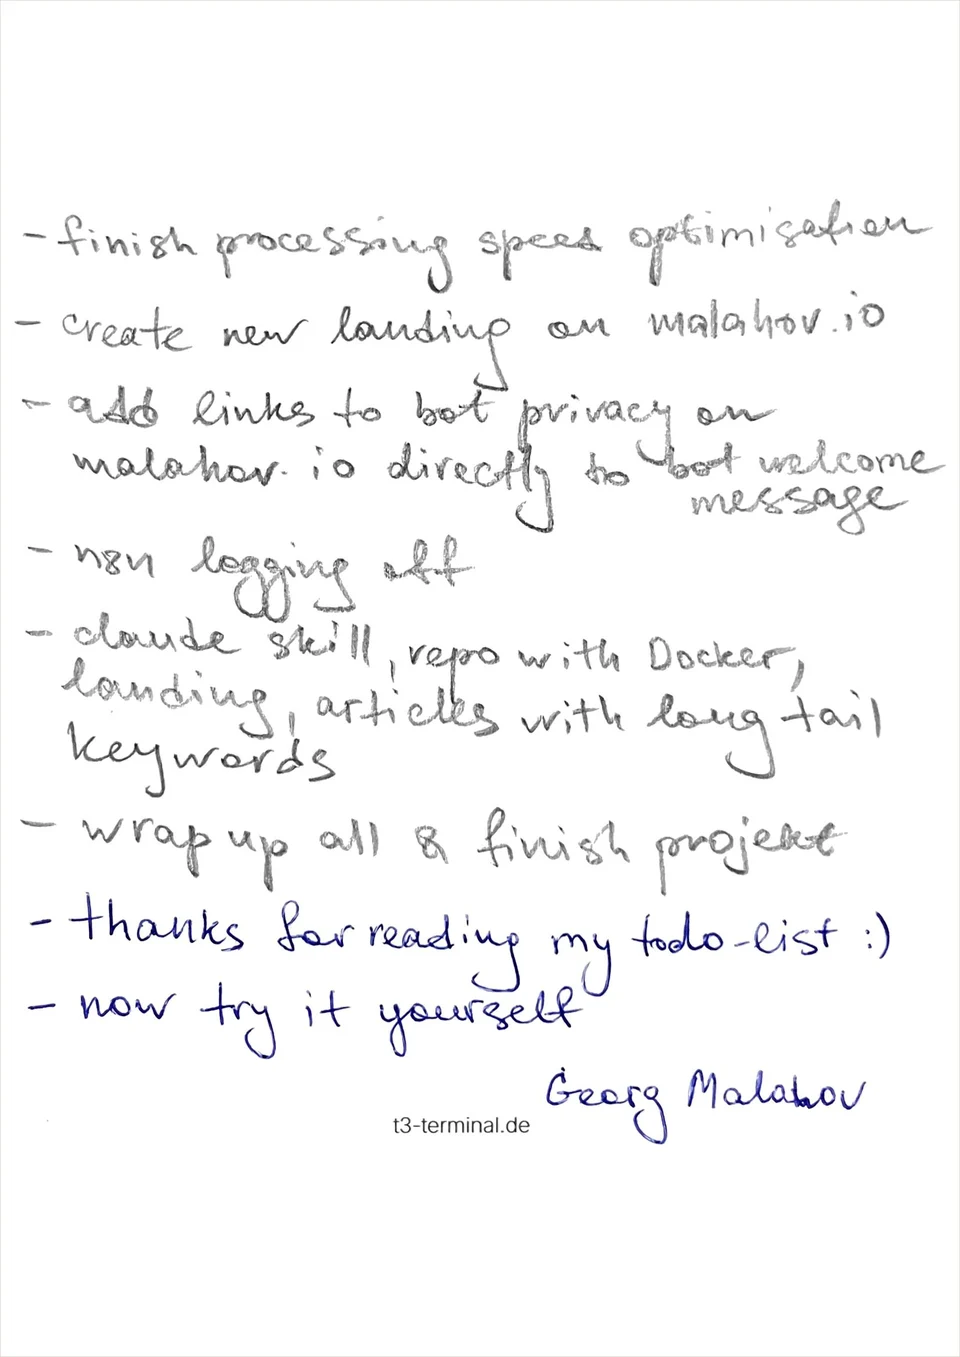
То же самое после обработки: лист выправлен, стол и пружина убраны, бумага белая. Карандаш остался серым, ручка — синей.
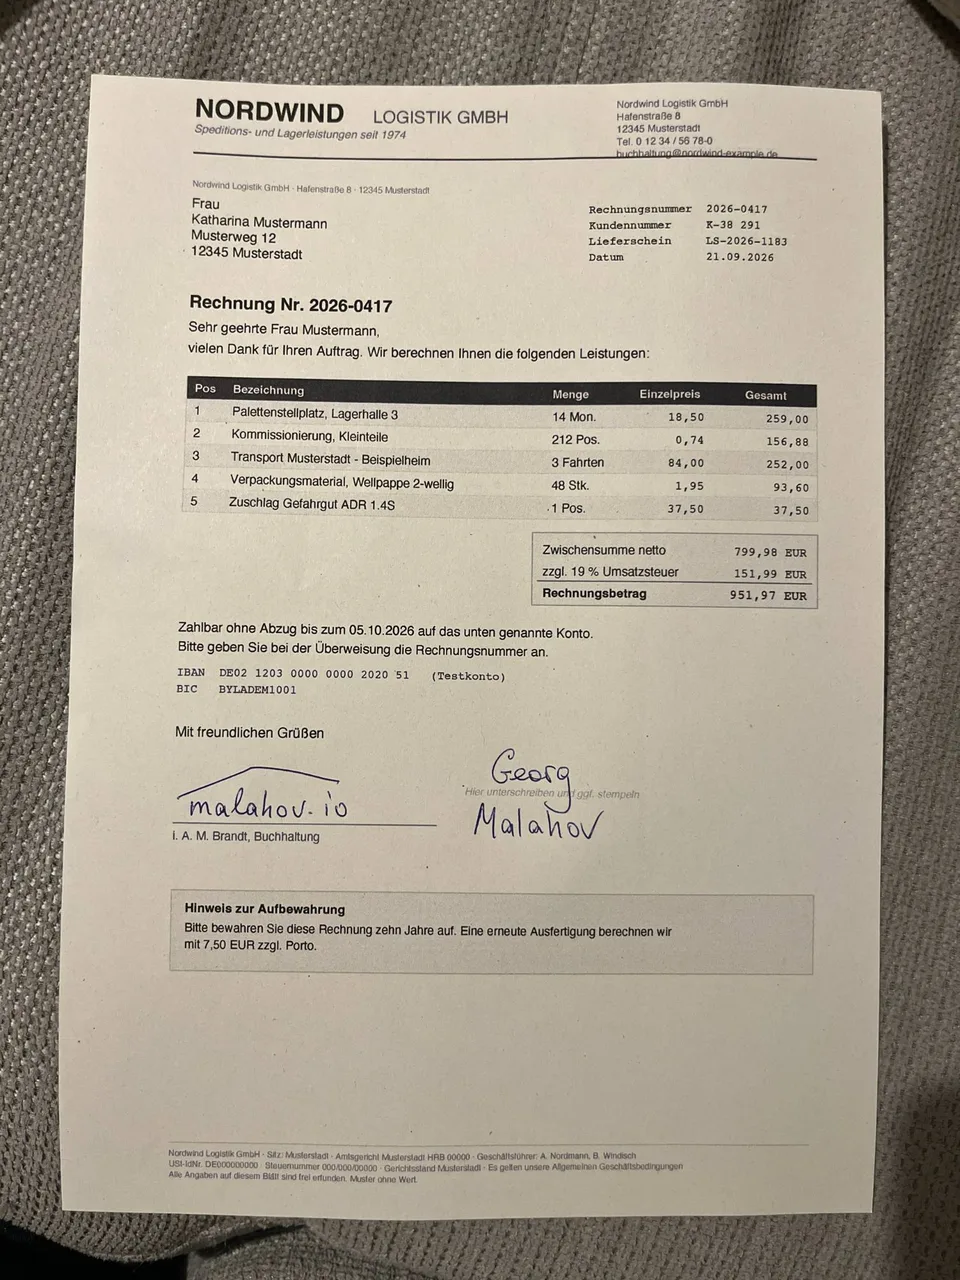
Самый обычный случай: распечатанный счёт снят вечером на диване. Серая ткань вокруг, тень в углу, лист чуть под углом, подпись синей ручкой. Все данные в счёте выдуманы.
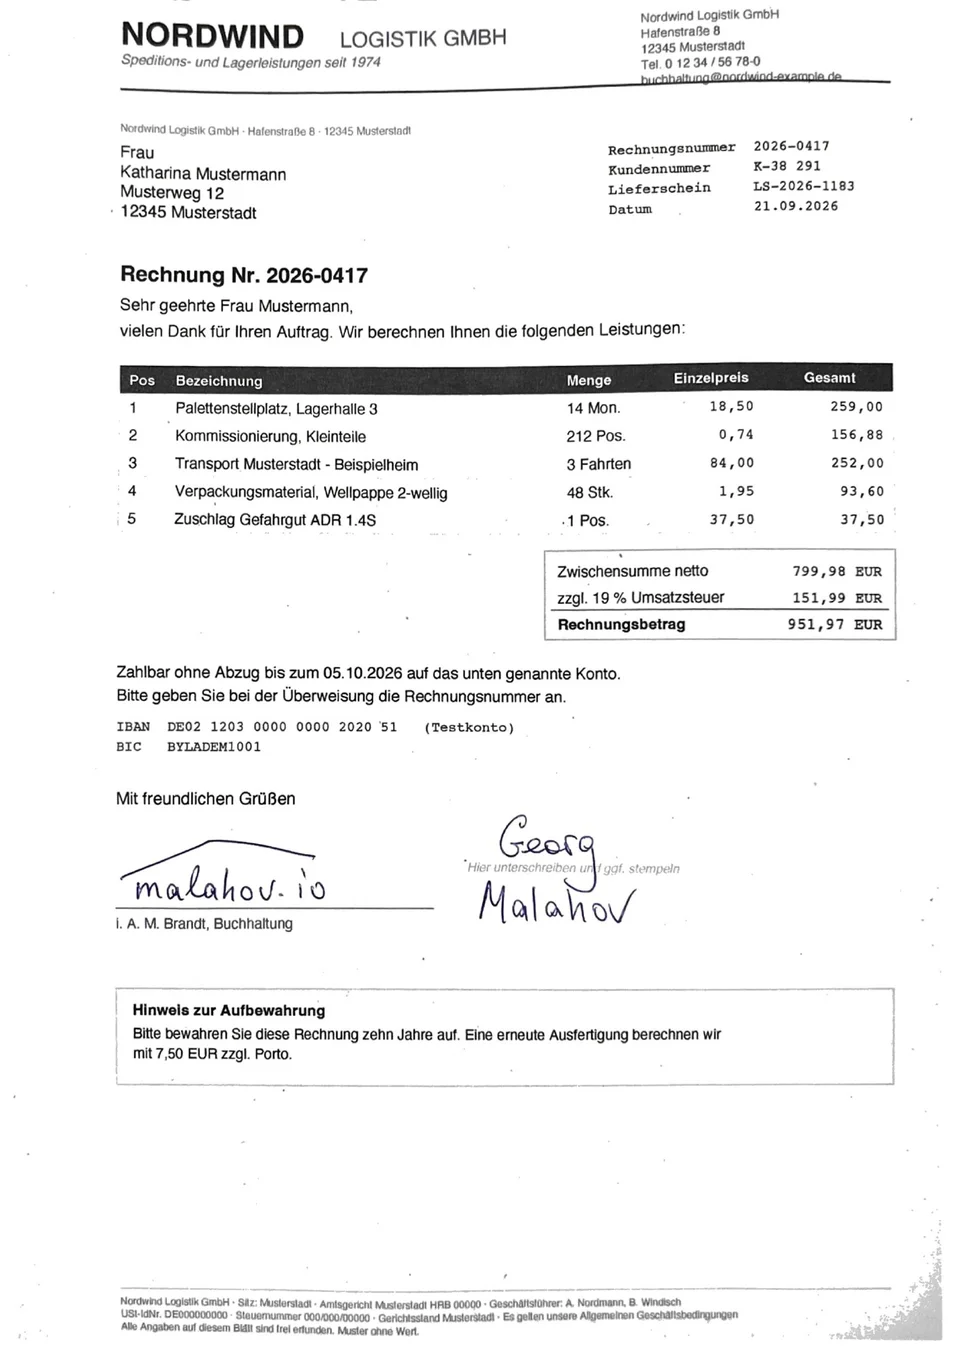
После: лист выпрямлен, бумага белая, таблица читается, подпись синяя. Видно и то, что не вышло: в правом нижнем углу, где тень была гуще всего, остался след ткани.
Попробуйте на том, что лежит перед вами
Бесплатно, без регистрации и без установки. Один снимок — и станет понятно, годится это вам или нет.
Открыть бот в TelegramЕщё умеет
- Собирает многостраничный документ. Отправьте страницы одним альбомом — вернётся один PDF в том порядке, в каком они шли.
- Отличает документ от снимка. Если в кадре нет листа, обработка не применяется: фотография просто аккуратно ложится на страницу. Так же можно собрать PDF из обычных снимков.
- Возвращает страницы картинками. Команда
/jpegпревращает последний PDF обратно в изображения — удобно, когда на той стороне просят «пришлите фото». - Говорит на трёх языках. Русский, немецкий и английский — по языку вашего клиента Telegram.
- Работает и без Telegram. Это обычный контейнер:
docker runс папкой — и PDF собирается у вас на машине, без интернета. - Живёт внутри Claude Code. Есть скилл — Claude сам возьмёт ваши снимки и соберёт PDF, не выходя из терминала. Он лежит среди остальных скиллов.
Приватность
- Снимки не хранятся. Журнал n8n не сохраняет данные ни одного запуска — ни удачного, ни упавшего. Это выставлено намеренно: через бота идут чужие документы.
- Обработка на своём сервере. Не в облаке, не через чужой API. Внутренний сервис наружу не смотрит вовсе.
- Для обработки — никакого облака. В обычном образе нет ни OpenCV, ни NumPy, ни моделей — просто Python и ImageMagick. У второго есть локальная офлайн-модель, и она лежит внутри самого контейнера. Ваш снимок обрабатывается на этом сервере и никуда с него не отправляется. До сервера он доходит через Telegram — как любое сообщение в нём.
- Остаётся одна ссылка. Бот запоминает идентификатор последнего готового PDF на неделю — только чтобы работала команда
/jpeg. Сам файл лежит в вашем чате в Telegram, как любое другое сообщение. - Счётчики — без имён. Бот записывает, сколько страниц обработано, сколько это заняло и по какой ссылке вы пришли, а если вы сами оставили оценку или отзыв — и его. Имён, username и содержимого документов там нет.
- Код открыт. Лицензия MIT, всё на GitHub — можно прочитать и запустить у себя.
- Юридически точный текст — в политике конфиденциальности, раздел 12: что передаёт Telegram, какие основания и как удалить свои данные.
Частые вопросы
Сколько это стоит?
Нисколько. Ни оплаты, ни лимитов, ни регистрации — и это не акция. Обработка идёт на одном небольшом сервере, который пока справляется в одиночку и стоит примерно ничего. Если однажды перестанет справляться, я скажу об этом прямо, а не повешу форму оплаты молча.
Долго ждать?
Около полуминуты на страницу. Альбом из восьми снимков — несколько минут: страницы считаются по очереди, чтобы не занять весь сервер одному пользователю.
Как получить лучшее качество?
Самое простое — переключить HD в окне отправки фотографии: Telegram по умолчанию сжимает снимок так, что часть деталей теряется ещё до обработки. Совсем без потерь получится, если отправить снимок файлом — через скрепку, пункт «Файл», — но это на пару тапов дольше.
И постарайтесь, чтобы лист целиком попал в кадр: по его краям определяется настоящий размер страницы.
А если документ не A4?
Страница всё равно будет A4 — это формат, который просят формы загрузки. Широкий документ ляжет на альбомную страницу: переворачивается страница, а не содержимое, так что текст остаётся читаемым.
Текст будет распознан?
Нет. a4norm делает изображение страницы, а не текстовый слой. Если нужен поиск по содержимому — это другая задача.
Чем это отличается от приложений-сканеров?
Их надо установить, многие просят аккаунт, а часть отправляет снимок в облако и показывает рекламу. Здесь нет ни установки, ни аккаунта, ни облака — и код можно прочитать.
Можно запустить у себя?
Да, это и есть основная форма:
docker run --rm -v "$PWD:/work" ghcr.io/georg-malahov/a4norm:latest \
  -o /work/document.pdf /work/page1.jpg /work/page2.jpg
Образ — около 40 МБ на загрузку и около 105 МБ после распаковки, в сеть он не ходит. Оба образа лежат в реестре GitHub, исходники Dockerfile — в репозитории.
А из Claude Code можно?
Да, для этого есть скилл: Claude распознаёт просьбу вроде «сделай скан» и запускает тот же самый код. Все скиллы — здесь.
Почему образа два?
latest — сам инструмент: около 105 МБ на диске, обычный Python и ImageMagick, никаких моделей. full — то же самое плюс одна модель сегментации, которая включается только если лист не удалось найти по яркости: например, белую страницу положили на светлый стол. Весит он больше, и нужен далеко не всем.
Бот работает на full — просто как страховка на случай неудобного снимка. Пример «до и после» с этой страницы выходит в latest точно таким же: лист нашёлся по яркости, модель не понадобилась.